
为研究者和知识工作者打造
整理研究用 PDF,无需移动文件。
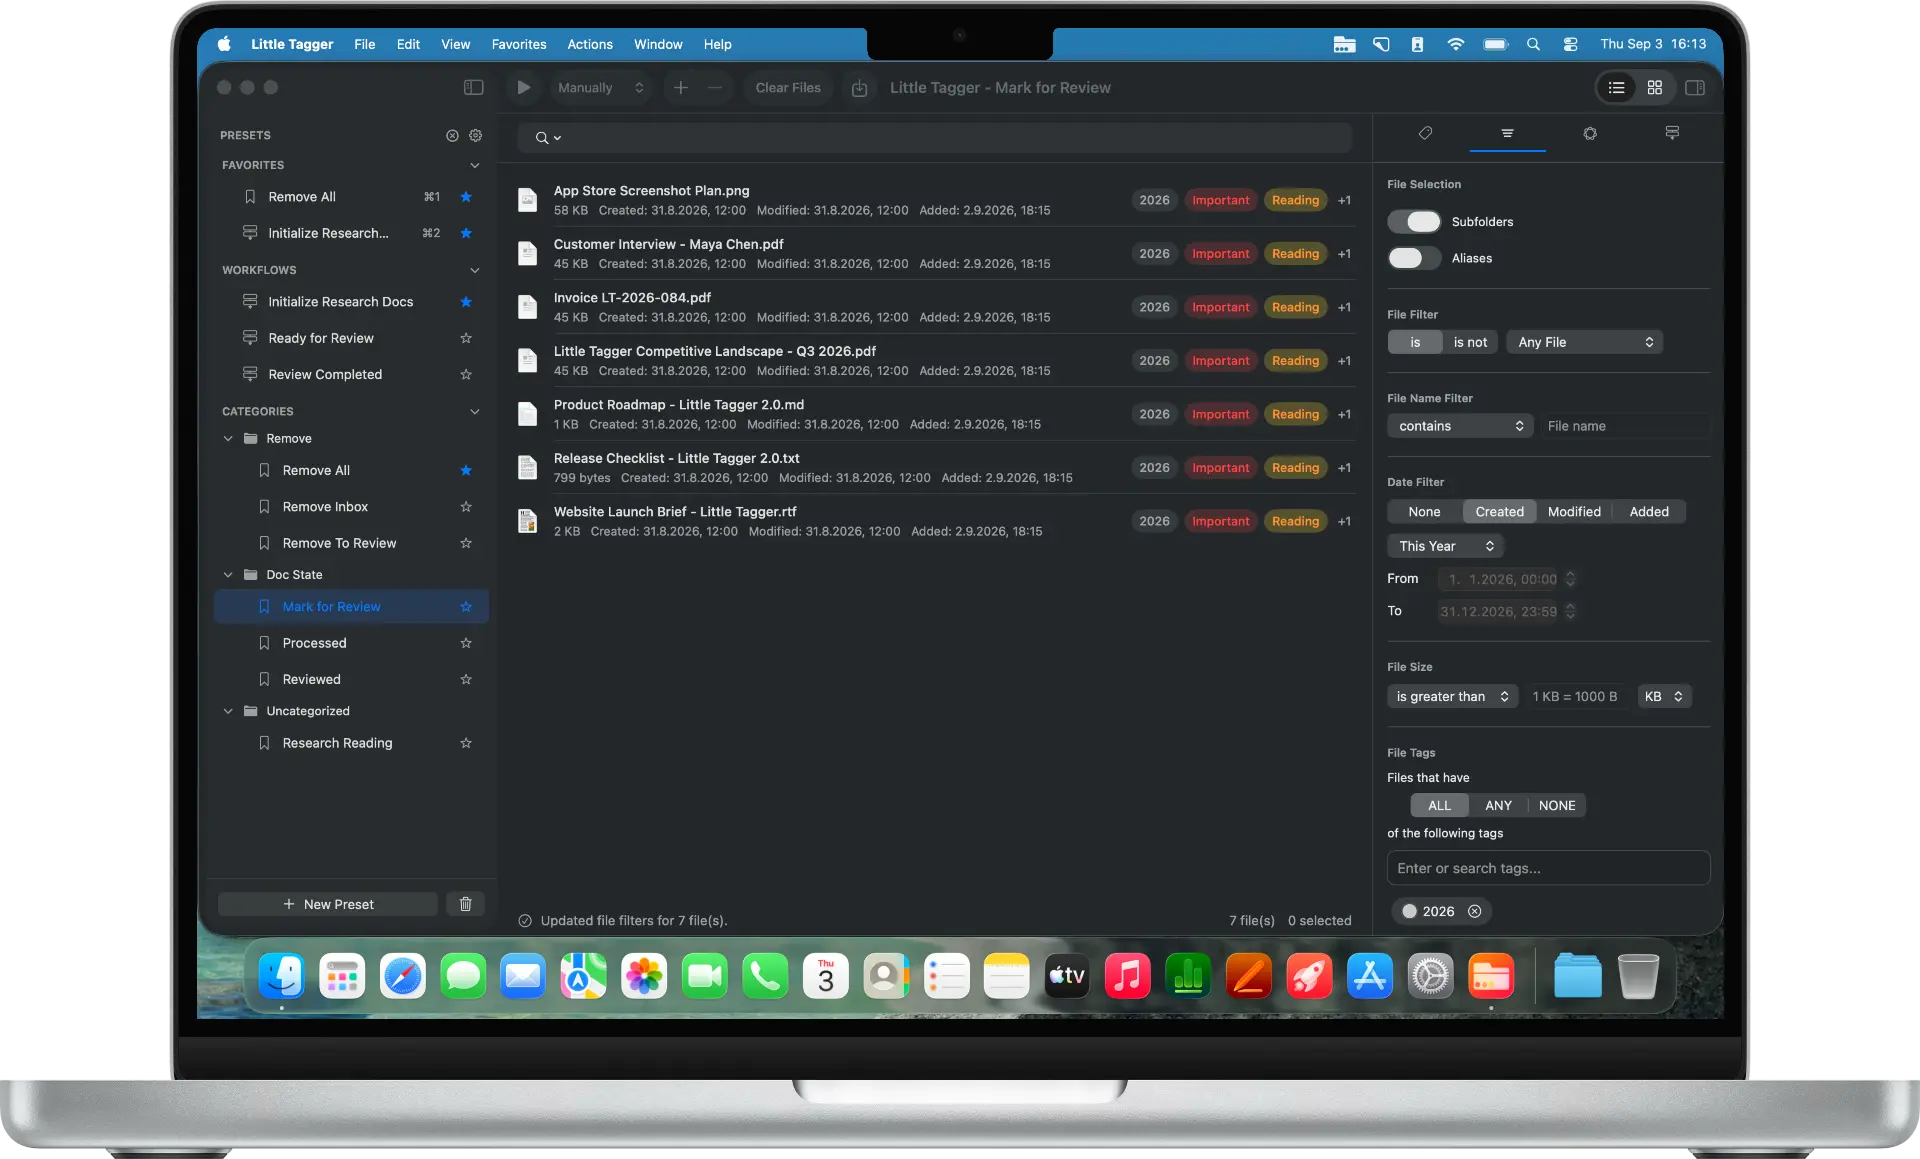
Little Tagger 使用原生访达标签整理 PDF、报告、转录文本和数据集。文件保留在原有文件夹中,通过项目、主题、来源和审阅状态标签,关联研究中的各类资料。
为每一批新文件复用预设,继续使用熟悉的 App 阅读和记笔记。Little Tagger 补充文献管理工具的功能,而非取代它。
难点不在于保存文件,而在于记住它的意义。
研究资料积累得很快。论文以 PDF 形式到来,访谈转录与笔记放在一起,为一个项目下载的报告,半年后又与另一个项目相关。数据集、参考图片、演示文稿和辅助材料,最终都被存放在磁盘的某个角落。
文件夹层级很擅长回答一个问题:我把这个文件放在哪里了?但研究工作通常需要同时回答其他几个问题。
- 它支持哪个项目?
- 它讨论什么主题?
- 它来自哪里?
- 我审阅过了吗?
- 它是原始资料、参考文献,还是辅助证据?
- 它是否也与另一个项目相关?
文件夹层级越深,您就越需要选择文件的某一种归类方式,而舍弃其他可能性。
接着,细微的不一致开始出现。
访达标签可以解决多维分类的问题,前提是标签体系本身仍然易于管理。研究标签列表通常会以一些熟悉的方式逐渐变乱。
这些不一致通常不是因为有人刻意设计了一套糟糕的体系,而是逐渐积累的:找不到合适的标签,就匆忙新建一个;某个项目采用了稍有不同的命名规则;文件早已进入下一阶段,临时状态标签却迟迟未被移除。
最终,标签列表本身也成了需要手动管理的负担。
每一批新资料到来,同样的分类工作又要重来。
假设您为同一个研究项目下载了 12 篇论文。它们都需要相同的项目标签,大多数是期刊文章,起始状态都是“待审阅”,其中几篇还涉及相同主题。
在访达中,您仍需逐个文件或逐批重复这些分类。下周又有一批资料到来,整个过程再次开始。
问题已不在于访达是否支持标签。它当然支持。真正的问题是,访达几乎没有提供一套机制,帮助您复用、维护并随规模扩大而完善标签操作。
文件留在原处,用标签补充关联信息。
Little Tagger 使用标准访达标签,因此您无需放弃现有文件夹结构。标签成为补充的一层信息,用于表达跨越文件夹边界的关联。
- Project Atlas/
- Papers/
- Reports/
- Interviews/
- Data/
场景
贴近实际的研究工作流程
您正在开展 Project Atlas,这是一个研究专业服务领域采用 AI 的长期项目。一周内,您收集了 14 篇学术论文、3 份行业报告、2 份访谈转录、一份调查结果电子表格,以及若干截屏和参考图片。
传统的文件夹整理能解决部分问题:论文、报告、访谈、数据和图片分别存入各自的子文件夹。这样确实有用,但仍无法告诉您哪些文件讨论治理、哪些包含定量证据、哪些资料仍待审阅,或哪份报告也与另一个项目相关。
完全用访达标签构建的体系,可以像下面这样。
重点在于多维结构,而非这套具体分类。您自己的分类维度可以完全不同。
将重复的部分保存为预设。
Project Atlas 的每篇新论文,最初都有一些相同的分类。与其反复选择这些标签,不如将重复的操作保存为预设。
每篇论文仍可使用不同的主题标签。预设不会强迫所有文件采用相同分类,而是省去真正重复的那部分工作。
需要一起执行的多个操作,可以组成工作流程。
当标签处理有先后顺序时,工作流程尤其有用。它将可复用预设组合起来,并从上到下依次运行。
哪些文件进入 Little Tagger,以及工作流程何时运行,都由您决定:手动、立即,或在文件进入工作区后短暂延迟再运行。不会在后台监控文件夹。
- 1移除临时导入标签
- 2添加 Project Atlas
- 3添加“期刊文章”
- 4添加“待审阅”
难以决定还该添加哪些标签时。
重复使用的标签通常容易确定。更难的往往是主题:这篇论文究竟讨论什么,现有标签体系中的哪些标签适合它?
在受支持的 Mac 上,Little Tagger 可使用 Apple 智能,根据工作区内的文件推荐标签。建议可参考文件内容、文件名、元数据、图像、现有标签和其他可用信息。所有处理均在设备上进行:无需账户、无需上传,也不使用第三方 AI 服务。
只有您决定后,才会添加标签。 建议是供您审核的选项,不会自行更改标签。 了解保护隐私的设备端建议如何工作 。
研究分类体系不断增长,也应始终好用。
项目会结束,术语会变化,临时标签会过时,相似名称也会出现。Little Tagger 为标签库本身提供了专门的检查空间:查看未使用的标签、相似名称、未分配给任何文件的标签、分组结构,以及标签实际使用的位置。
收获的不只是“更多标签”,而是更多关联信息。
- 一篇论文可以关联多个研究方向,无需复制文件。
- 无需重新整理文件夹,即可更新进度。
- 重复的分类工作不必再从零开始。
- 旧标签可以及时维护,而不只是不断累积。
- 底层标签保持一致,搜索也变得更有用。
Little Tagger 不是文献管理工具,也不会取代 Zotero、DEVONthink 或笔记数据库。它使用原生访达标签,整理您已经保存在 Mac 上的文件。
如果您也有这些需要…
- 您将 PDF、报告、笔记、数据集或参考资料直接保存在 Mac 上。
- 您的文件往往同时属于多个有用的类别。
- 您反复添加相同的项目、来源或进度标签。
- 您的访达标签列表越来越难维护。
- 您希望改善整理方式,但不想将所有内容移入专有数据库。
少花时间整理研究资料,保留更多有用的关联。
数秒内为文件添加标签,自动完成重复操作,轻松掌控整个标签体系。 注重隐私,原生体验,专为 Mac 打造。
免费试用 7 天 · 无需账户 · macOS 15 或更新版本 · Apple 芯片